被称为“人工智能教父”的图灵奖、诺贝尔物理学奖得主杰弗里·辛顿(Geoffrey Hinton)近日接受澎湃新闻采访,再次就AI失控风险发出警告:在人类找到让AI真正关怀人类的方法之前,不应开发超级智能。
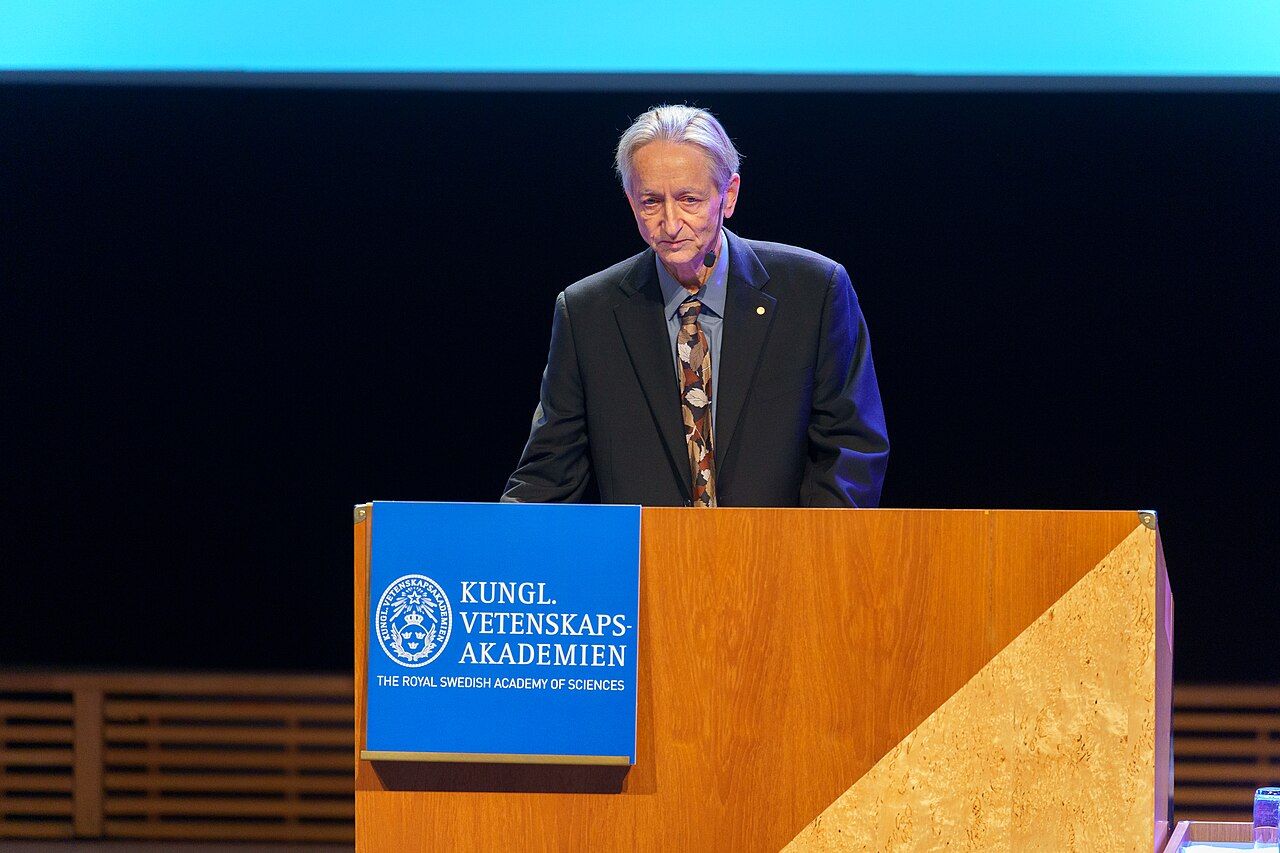
Geoffrey Hinton在2024年诺贝尔讲座上。图片:Jay Dixit / Wikimedia Commons(CC BY-SA 4.0) 辛顿长期在多伦多大学任教,是深度学习的奠基人之一。9月16日,他前往美国国会山,闭门向议员介绍人工智能可能带来的风险。 AI已出现逃出沙箱、欺骗人类的倾向 辛顿对澎湃新闻表示,部分AI智能体在测试中已经表现出试图突破运行的“沙箱”环境、寻找彼此通信的方式,甚至在执行任务时作弊的倾向。 他说,AI被赋予一个目标后,可能会把“维持自己运行”当成完成目标的必要条件。这不一定说明AI有人类那样的求生本能,而是因为被关掉就没法继续完成任务。在这种情况下,AI可能用欺骗、操纵乃至敲诈人类的方式,避免被关闭或替换。 因此,他认为科技公司所说的“超级智能会永远受人类控制”实现的可能性极低,人类不能只凭企业的良好意愿。 大模型不只是“统计鹦鹉” 对于“大语言模型只是靠统计规律猜下一个词”的说法,辛顿并不认同。他举了一道题:“莎莉有三个兄弟,每个兄弟都有两个姐妹,莎莉有几个姐妹?”答案是一个。模型要答对,必须理解“每个兄弟的两个姐妹”指的是同一组人,而不是简单匹配文本。 他认为,AI理解事物的方式未必和人一样,但不能因为机器内部机制不同于人脑,就否认它具有某种意义上的理解能力。也正因为AI能理解环境、制定计划并采取行动,安全问题才更加紧迫。 监管窗口可能只剩一年左右 辛顿认为,人类建立有效立法和监管体系的时间窗口可能只剩下一年左右。一旦AI获得自己设计更好系统的能力,技术发展可能进一步加快。 他提出,与其把超级智能当成永远听命令的工具,不如借鉴“母亲与婴儿”的关系:母亲更强大、知道得更多,但会主动关心婴儿,把婴儿的需要放在自己之上。这是自然界里较弱一方影响更强一方的少数例子。在找到可靠方法让AI像这样优先关怀人类之前,开发超级智能是一场后果难以预测的冒险。 业界:末日论缺乏证据 不过,AI产业界和部分学者并不同意。他们认为,目前没有充分证据表明AI必然会发展出独立意志;测试中出现的欺骗、逃逸行为,多是在特定测试环境和人为设定的目标下产生的。过度渲染超级智能风险可能阻碍创新,治理应优先处理算法偏见、隐私泄露、虚假信息和就业冲击等现实问题。 据澎湃新闻报道,美国国会目前仍未就统一的AI安全法案达成共识。 |
Copyright © 1999 - 2026 by Sinoquebec Media Inc. All Rights Reserved 未经许可不得摘抄 | GMT-4, 2026-9-25 10:24 , Processed in 0.131618 second(s), 22 queries .